就业企航(第30期)| 企业岗位笔试真题拆解
- 2026-11-13 16:37:25
信息与控制工程学院
就业企航“企业岗位笔试真题拆解”栏目
秋招笔试战已打响!华为、阿里、百度等大厂2025年笔试题难度大幅提升,但信控er专业能力恰是解题关键,本期精选了华为2025年秋招AI岗笔试题,助力每一位求职路上的信控er~
1.某厂次品率为0.02,随机抽取100件,次品数X近似服从哪种分布?(C)
A、伯努利分布
B、均匀分布
C、泊松分布
D、正态分布
2.生成较长且连贯的文本,哪类模型更合适?(C)
A、最大熵模型
B、决策树
C、LSTM
D、隐马尔可夫模型(HMM)
3.用迭代xk+1=cos(xk)求解方程x=cos x,其收敛性描述正确的是:(A)
A、对任意初值都收敛到唯一实根
B、不稳定,因余弦有界线性无界
C、有两个实根,收敛根取决初值
D、收敛时为二次收敛
4.下列用于检验正态性的做法中,错误的是:(C)
A、直方图
B、拟合优度检验
C、T检验
D、偏度与峰度
5.用牛顿法求(x+3)x²=0的根,初值x₀=3,其收敛速度为:(C)
A、二次
B、对数
C、线性
D、超线性
6.已知t=[0,1,2]秒时应力为[100,120,150]MPa。二次插值P₂(t)=100+20t+5t(t−1),真实应力 σ(t)=100+20t+5t²。求t=1.5 秒的绝对误差:(C)
A、0.0 MPa
B、5.0 MPa
C、7.5 MPa
D、2.5 MPa
7.设线性映射T:R²→R²。标准基向量e₁=[1 0],e₂=[0 1]在T下的像分别为T(e₁)=[3 1],T(e₂)=[−1 2]。求向量v=[4 3]的像T(v)为:(B)
A、[10;5]
B、[9;10]
C、[12;8]
D、[11;6]
8. 向量组α₁,α₂,α₃线性无关。设β₁=k₁α₁+α₂+k₁α₃,β₂=α₁+k₂α₂+(k₂+1)α₃,β₃=α₁+α₂+α₃。若{β₁,β₂,β₃} 线性相关,则k₁,k₂满足:(D)
A、k₁=1且k₂=0
B、k₁=1或k₂=1
C、k₁=1且k₂=1
D、k₁=1或k₂=0
9.概率密度f(x)=1/(b−a)(x∈[a,b]),其余为0,对应的分布是:(D)
A、正态
B、指数
C、泊松
D、均匀
10.给u=[2 −1 3],v=[4 0 −2],A=uvᵀ。求A的第2行第3列元素:(B)
A、0
B、2
C、6
D、−4
11.一个分类模型在训练集准确率很高,但在测试集准确率明显更低,这种现象最可能是:(B)
A、欠拟合
B、过拟合
C、无法判断
D、恰好拟合
12.特征X满足E[X]=10、Var(X)=4,线性变换Y=3X−5,则Var(Y)=:(C)
A、12
B、7
C、36
D、31
13.使用PCA降维时,选择主成分的主要依据是:(A)
A、主成分的方差贡献率
B、数据类别分布
C、样本分布密度
D、特征间相关性
14.线性变换T:ℝⁿ→ℝᵐ,以下说法正确的是:(A)
A、T(cu)=cT(u)
B、零向量经T后不一定是零向量
C、线性变换不能改变向量维度
D、T(u+v)=T(u)+T(v)仅当u⊥v
15.关于Transformer解码器的描述,哪一项是错误的?(D)
A、含编码器-解码器的交叉注意力层
B、含掩码自注意力层(Masked Self-Attention)
C、第二个多头注意力层的K、V来自编码器输出
D、第二个多头注意力层使用了Mask掩码
16.EM算法中,GMM的M步需要满足的是:(ACD)
A、各成分权重之和为1
B、协方差必须是对角阵
C、协方差矩阵需正定
D、均值按后验责任度加权更新
17.关于线性变换,下列正确的是:(ABD)
A、若T为线性,则T(kα+mβ)=kT(α)+mT(β)
B、若T₁、T₂线性,则 T=T₁+T₂仍线性
C、T:ℝ³→ℝ²,T(x,y,z)=[x+y+1;z−2y]是线性
D、T:ℝ²→ℝ²,T([x;y])=[2x+y;x−3y]是线性
18.设{N(t),t≥0} 为强度为λ的泊松过程,以下说法正确的是:(ABCD)
A、E[N(t)]=λt
B、条件于N(t)=n,n 次到达时刻在 [0,t] 上独立同分布为均匀分布(有序为次序统计量)
C、首次到达时间T₁~Exp(λ)
D、相邻到达间隔独立同分布,且与T₁独立
19.关于ReLU、Softmax、Sigmoid、Tanh的描述正确的是:(ABCD)
A、Tanh输出范围在[−1,1]
B、Sigmoid导数在0处最大,远离0趋于0
C、Softmax输出为概率分布,和为1
D、ReLU对负数输出0、对正数输出自身
20.相较单模态LLM,多模态大模型(MLLM)在多模态输入下的独特挑战包括:(ABCD)
A、多模态对齐(如图文语义对齐)
B、跨模态语义理解与生成
C、实时处理与推理延迟
D、参数规模显著增长
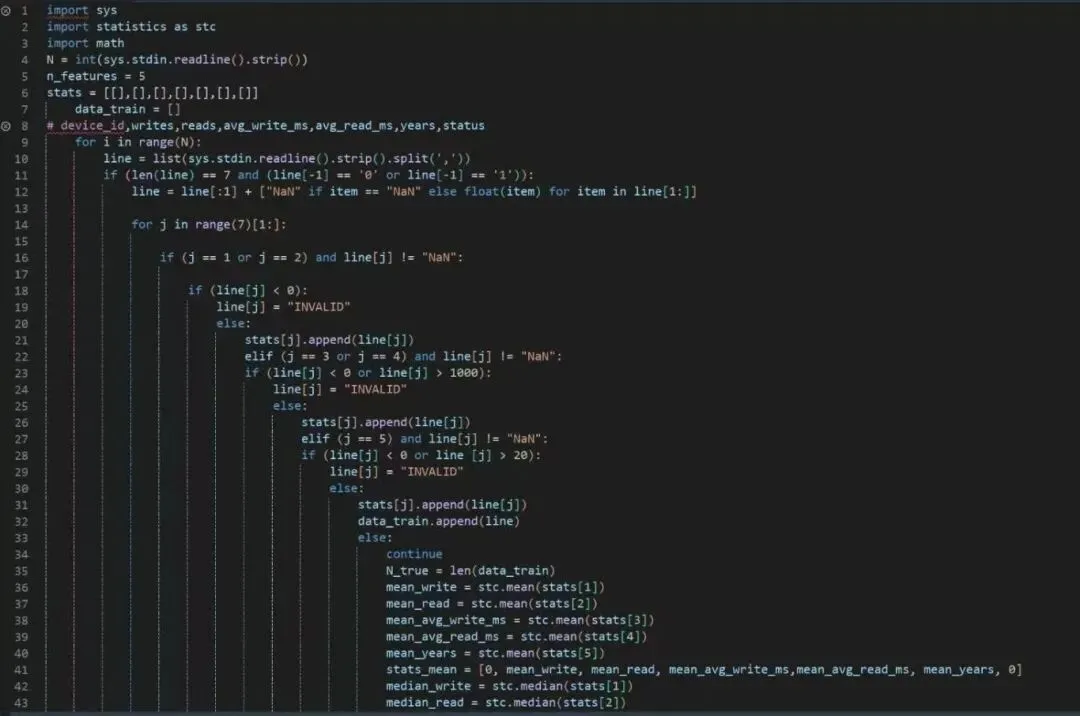
21.设备故障预测程序
在一套对象存储集群中,运维同学希望根据设备运行日志,提前判断设备是否有故障风险,从而把数据在故障前迁移到其他节点。每条日志包含以下字段:设备ID、写入次数、读取次数、平均写入延迟(ms)、平均读取延迟(ms)、使用年限(年)、设备状态(0 正常/1 故障)。
请你实现一个设备故障预测程序,基于训练数据学习一个逻辑回归模型,并对给定的待预测设备输出是否故障的判定结果。
数据清洗规则
缺失值填充:数值字段出现字符串 NaN 时,用该字段在训练集中“有效数值”的均值进行填充。有效数值的含义见“异常值处理”。
异常值处理:若出现以下越界值,则视为异常,用该字段在训练集“有效数值”的中位数替换。
1.写入/读取次数:小于0
2.平均写入/读取延迟:小于0或大于1000
3.使用年限:小于0或大于20
说明:计算均值/中位数时,只统计训练集中“有效数值”(即不含NaN,且不越界)。若某字段在训练集没有任何有效数值,则该字段的均值与中位数都按0处理。
标签缺失:训练样本若无状态字段或无法解析为0/1,丢弃该行,不参与训练,也不参与统计均值/中位数。
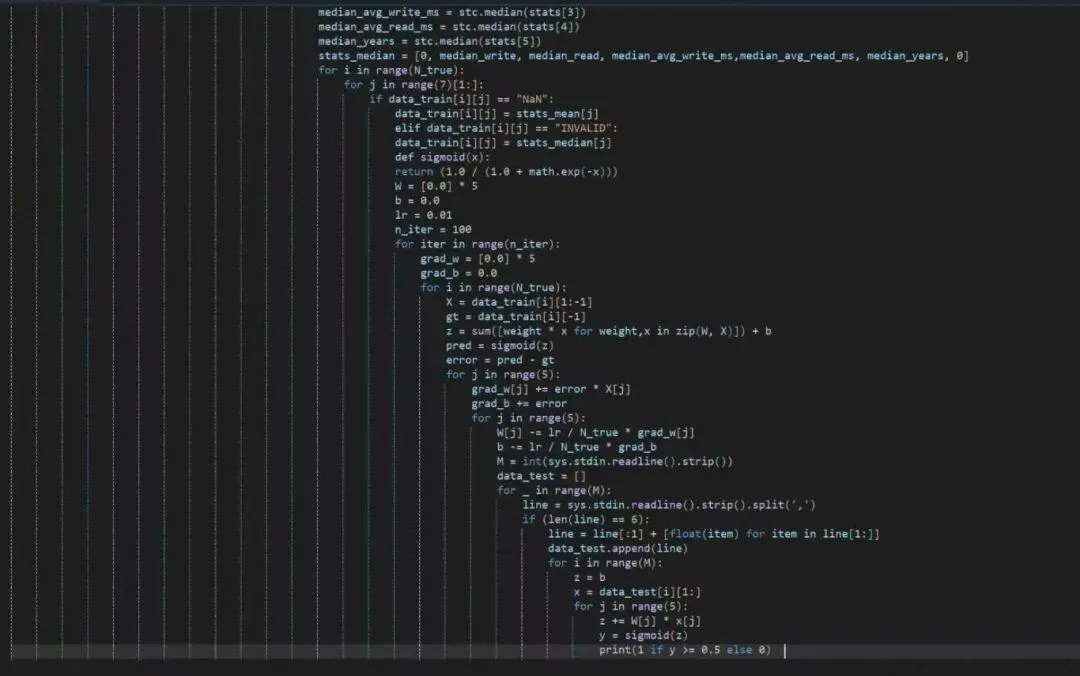
模型与训练
模型:二分类逻辑回归,带偏置项w0。
-训练方法:批量梯度下降(BatchGD),每次迭代用全部训练样本,学习率0.01,迭代100次,初始权重全0。
题解
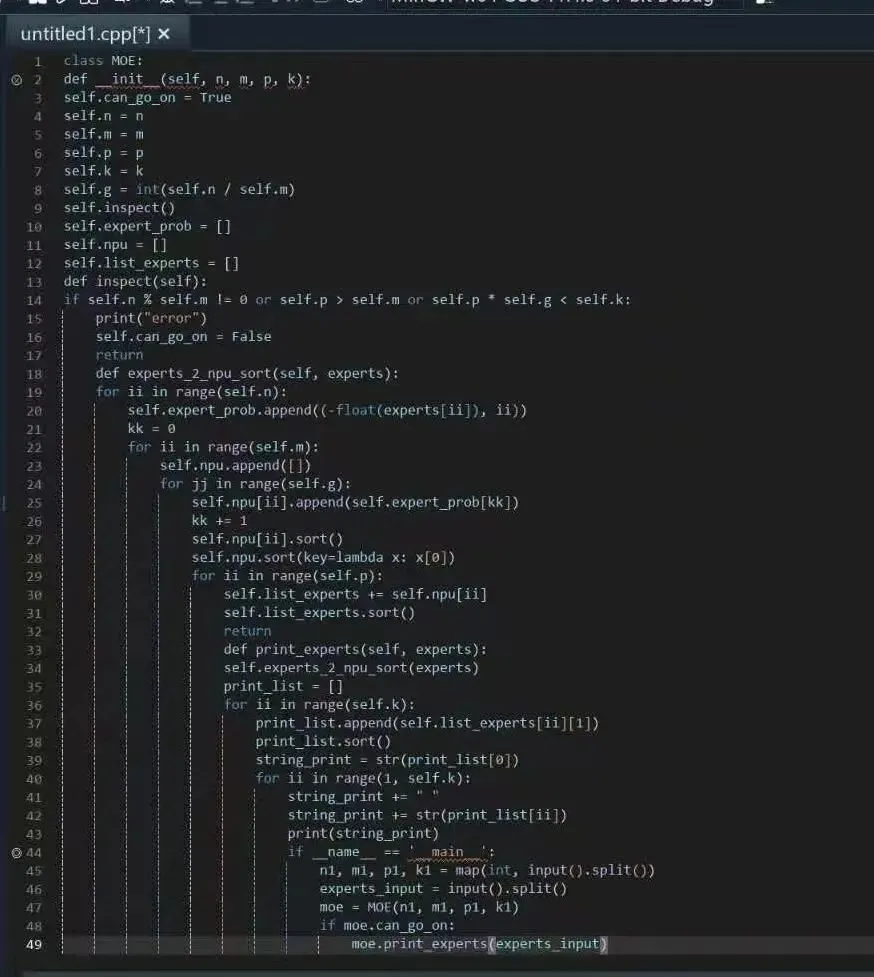
22.MOETop-k路由
在一个稀疏MOE模型中,有n个专家顺序编号为0…n-1,这些专家被平均分布到m张NPU卡上,每张卡上一组,且同组专家编号连续。为降低跨卡通信,现将路由目标限制在最多p张NPU上:
1)先对每组求组内概率最大值及其专家编号,作为该组的代表值;
2)把所有组按“代表概率”从高到低排序,若概率相同则组号小的在前,取前p个组;
3)仅在上述p个组包含的所有专家里,按“概率降序、编号升序”挑选前k位的专家编号作为最终路由目标。
约束与异常
若n不能被m整除,则无法平均分组,输出error。
若p>m,输出error。
设每组大小g=n/m,若可选专家总数p·g<k,无法选够k人,输出error。
题解:
一、单选题
1.下面这段代码执行的功能是什么?(C)
functionforward(x,W,b):
logits=Wx+b
exp_values=exp(logits)
returnexp_values/sum(exp_values)
A、全连接层+Sigmoid激活
B、全连接层+全局池化操作
C、全连接层+Softmax激活
D、全连接层+均值池化操作
2.Transformer中位置编码的主要作用是?(B)
A、归一化输入
B、引入序列顺序信息
C、增加非线性
D、减少计算量
3.线性方程组{4x+y=6,x+3y=3},初始解(x₀,y₀)=(0,0),进行一次Jacobi迭代后,(x₁,y₁)是?(D)
A、(0,0)
B、(2,0.5)
C、(1,1)
D、(1.5,1)
4.关于大模型的“幻觉”(Hallucination)现象,下列说法错误的是:(C)
A、模糊或复杂的提示词输入可能导致幻觉
B、模型生成看似合理但与事实不符的内容
C、增加训练数据多样性可以完全消除幻觉
D、RAG技术可缓解幻觉问题
5.已知矩阵A是3阶不可逆矩阵,α₁、α₂是齐次方程组Ax=0的基础解系,α₃是矩阵A的λ=2的特征向量,则不是特征向量的是:(D)
A、α₁+2α₂
B、−5α₃
C、3α₁−4α₂
D、2α₁+α₃
6.在KMeans(欧式距离)中,簇中心C₁:[1,1],C₂:[1,−1],C₃:[−1,−1],C₄:[−1,1],样本[2,−2]属于:(C)
A、C₃
B、C₁
C、C₂
D、C₄
7.矩阵A=[[1,2,3],[4,5,6],[7,8,9]]的零空间维度是?(A)
A、1
B、2
C、0
D、3
8.对于n×n实对称矩阵A,以下哪个说法正确?(A)
A、A的特征值一定都是实数
B、A的奇异值一定都是复数
C、A不能进行QR分解
D、A一定可以进行LU分解
9.若某项目有n位选手,每两人都对战,前m人晋级。一个选手最少需要赢几场才能确保晋级?(A)
A、ceil((2n−m−1)/2)
B、ceil((m−1)/2)
C、ceil(((m−1)+(n−1)+1)/(m−n+1))
D、ceil(((m−1)*n)/m)
10.连续型随机变量的概率密度φ(x)一定满足:(D)
A、单调不减
B、大于1
C、0≤φ(x)≤1
D、非负且积分为1
11.在SVM中使用RBF核。调整参数C和gamma,哪项正确?(C)
A、减小C增强正则;减小gamma边界平滑
B、减小C减弱正则;减小gamma边界灵活
C、增大C减弱正则;增大gamma边界灵活
D、增大C增强正则;增大gamma边界平滑
12.Tokenizer的核心作用是什么?(D)
A、翻译成中文
B、转浮点向量
C、翻译成英文
D、转整数ID序列
13.已知P(A)=0.5,P(B)=0.6,P(B|A)=0.8,则P(B∪A)=?(A)
A、0.7
B、1.1
C、0.3
D、0.8
14.总体X的分布:P(X=1)=(1−θ)/2,P(X=2)=P(X=3)=(1+θ)/4。样本2,2,1,3,1,3,1,2,θ的最大似然估计为?(C)
A、1/2
B、3/5
C、1/4
D、2/5
二、多选题
15.关于奇异值分解SVD,以下说法错误的是:(C、D)
A、Σ对角元素非负降序
B、SVD适用于任意m×n矩阵
C、左奇异向量是AᵀA的特征向量
D、SVD唯一确定
16.对方程组{5x+y=2,x+3y=4}用Gauss–Seidel,初值(0,0)。正确的是:(B、D)
A、两步后x=0.08,y=1.28
B、一步后x=0.4
C、谱半径>1发散
D、一步后y=1.2
17.朴素贝叶斯垃圾邮件过滤,需要估计哪些概率?(A、B)
A、P(单词|类别)
B、P(类别)
C、P(单词1,单词2|类别)
D、P(单词)
18.CNN中属于线性变换的操作是:(A、C)
A、卷积
B、ReLU
C、全连接
D、池化
19.关于决策树与XGBoost,正确的是:(C、D)
A、XGBoost无正则
B、树越深泛化越好
C、利用梯度和Hessian
D、基尼不纯度越大越混杂
20.面向专业术语知识库的RAG系统,哪些结论准确?(A、C)
A、典型流程:向量化→检索→拼接生成
B、极小chunk尺寸最佳
C、通用分词器会稀释术语语义
D、离线大模型、在线小模型只需同系列
三、编程题
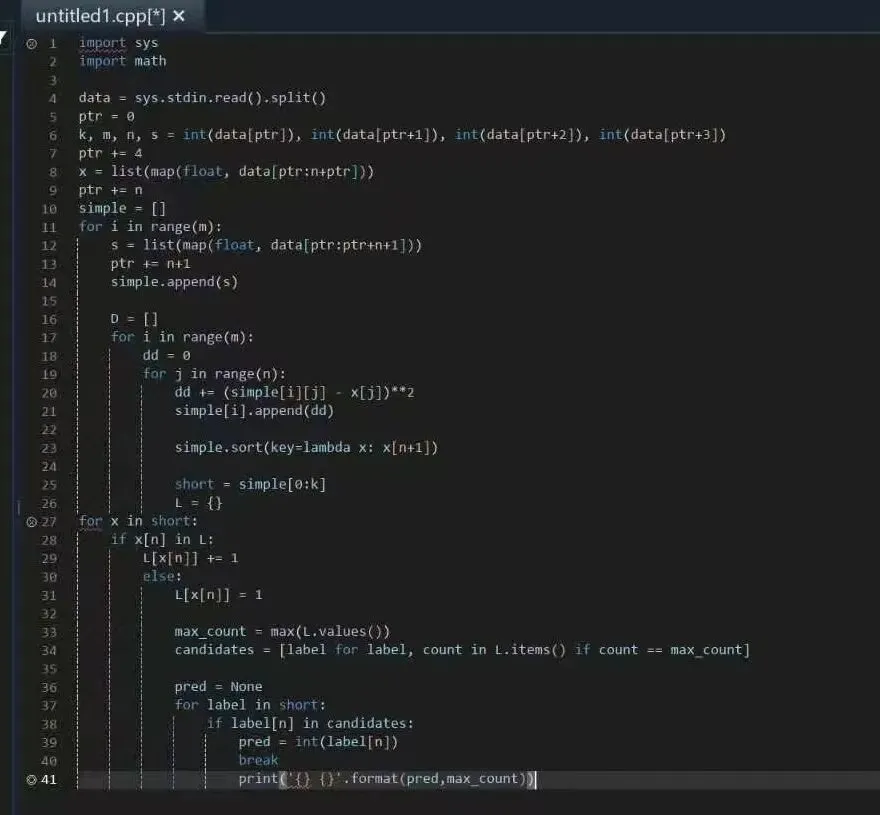
21.【K近邻分类器】
实现KNN分类:计算待测样本与训练样本的平方欧氏距离,选取前K个近邻,统计标签出现频次,最高频为预测结果;若频次并列,选距离最近的标签。
你需要为一个简单的多分类识别器补上“K近邻”判别模块。做法是:先度量待测样本与训练样本的距离,挑选出距离最近的K个样本,再用多数票决定最终类别。
操作要点(按流程执行):
先计算待测点到每个样本点的距离(为了效率,可直接用“平方欧氏距离”参与排序,结果等价)。将样本按距离升序排列,截取前K个作为近邻。统计这K个近邻的标签出现次数,频数最高的标签即为预测值。如出现“最高频数并列”,只在并列标签对应的近邻里,按由近到远的顺序挑第一个的标签。
约束与假设:
数据集已做归一化处理(不同维度量纲一致),特征保留两位小数。每个类别在数据集中都至少有一个样本。
距离采用欧氏距离
题解:
22.【决策树剪枝优化】
给定一棵二叉树和验证集,允许剪枝(替换子树为叶节点),输出使 F1 值最大的剪枝方案对应的最优 F1(保留六位小数)。
决策树若完全按训练集递归生长,往往能把训练样本分得很“细”,但一到未见过的数据就容易出错,即出现过拟合。为缓解这一问题,常用“剪枝”把某些子树整体替换成单个叶子,使模型更简单。
现在有一棵用于二分类的二叉决策树(标签1表示正类,0表示负类)。对非叶节点,按“第 fi个特征 ≤ thi走左子树,否则走右子树”的规则继续判断;到达叶子时直接输出该节点自带的 label允许在整棵树上任选若干处进行剪枝(把某个内部节点整体替换为叶节点,其输出为该节点给定的 label)。请在给定验证集上寻找使 F1 值最大的剪枝方案,输出最优 F1(四舍五入保留6位小数)。
题解:
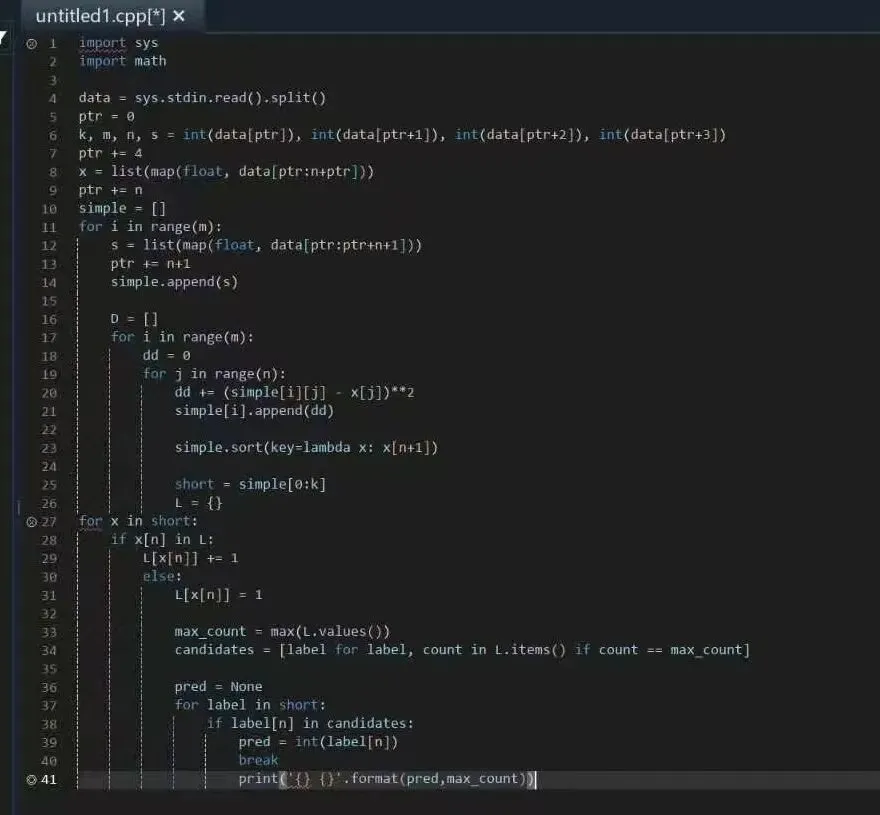
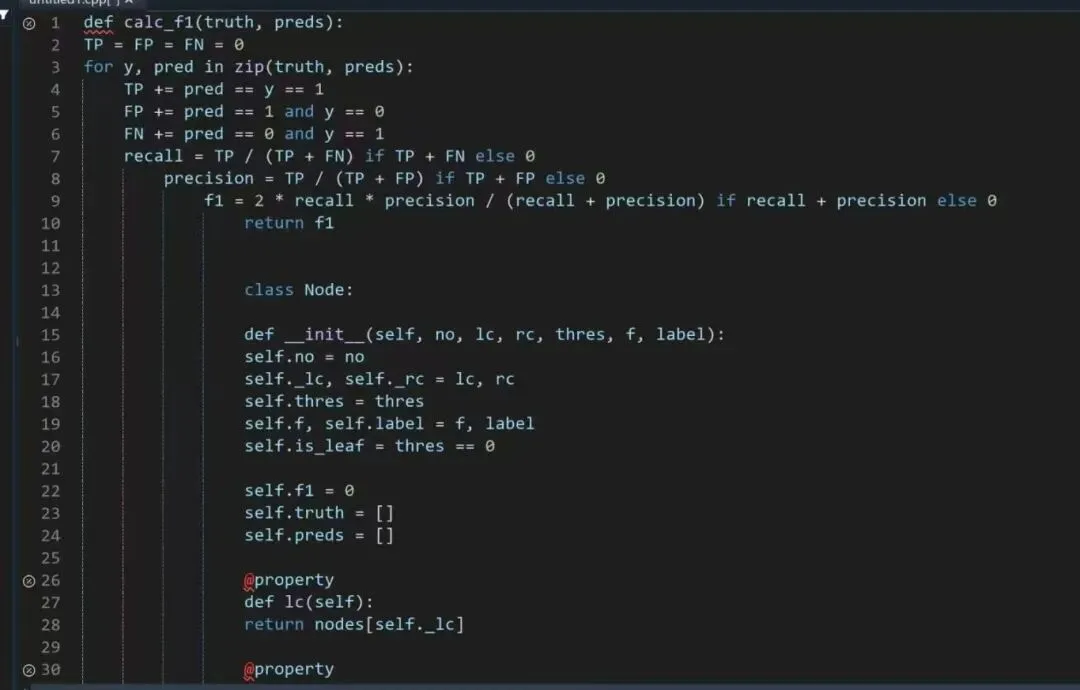
先实现二叉树的数据结构,然后递归实现决策树的推理过程。遍历验证集,每个节点记录当前以它为根的子树的真实标签列表和预测标签列表。然后遍历决策树,计算当前各个节点的局部F1值,当然根节点的F1就是在完整验证集上的全局F1。接下来是剪枝过程,其实不需要排列组合所有的情况,我们前序遍历,如果根节点合并了,就没有必要去遍历子树了;如果根节点没有合并,两个子树是否剪枝是在它们各自分配到的样本子集中进行的独立过程。我们只需要将预测标签列表暂时全部更新为该节点的label,重新计算F1值,如果比历史F1值要高,那就合并子树。最后我们再跑一遍完全一样的遍历和分类过程,计算根节点的F1值。
代码如下:
END
编辑:周嘉璞
校对:王凯
审核:杨晓寒
 微信扫一扫 · 添加人工客服
 QQ扫一扫 · 添加人工客服